

Le collezioni di manoscritti delle biblioteche storiche sono per definizione poco accessibili: i codici si consultano su appuntamento, in sala, con guanti e cautele. La digitalizzazione ha fatto circolare le immagini, ma non ha risolto il problema di fondo: un'immagine non si può interrogare. Uno studioso che voglia sapere in quali carte di un codice compaiono vicini due termini, davanti a un PDF di scansioni, non ha alternativa alla lettura integrale.
Il progetto Excerpta nasce per colmare questo scarto.
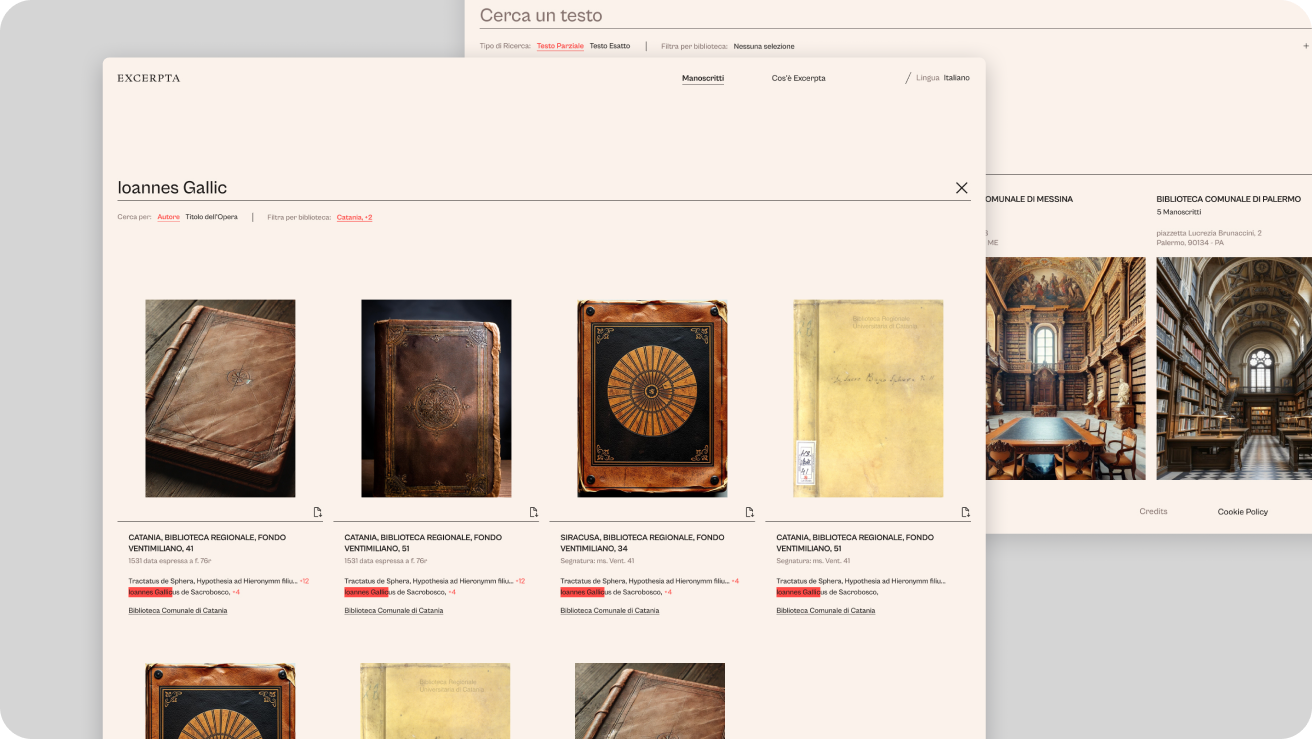
Abbiamo strutturato la piattaforma su tre livelli sovrapposti: la biblioteca che conserva i manoscritti, con una scheda descrittiva estesa; il codice, con la sua segnatura attuale e quelle antiche, i suoi contenuti, i suoi PDF scaricabili; e la singola carta, con la propria immagine, la trascrizione e l'apparato di commento. Chi arriva sul sito può partire dalla mappa delle biblioteche coinvolte e scendere fino alla riga di un testo.
La collezione su cui il progetto lavora conserva codici cinquecenteschi miscellanei, dove convivono nello stesso volume un trattato di astronomia medievale, una porzione di poesia latina classica, un testo umanistico e un'epitome di grammatica greca. Questa eterogeneità è stata un vincolo di progettazione: un codice non è un libro con un autore e un titolo, bensì un contenitore di opere diverse, ognuna con il proprio autore, il proprio intervallo di carte e la propria trascrizione.
La sfida
Tenere insieme immagine e testo
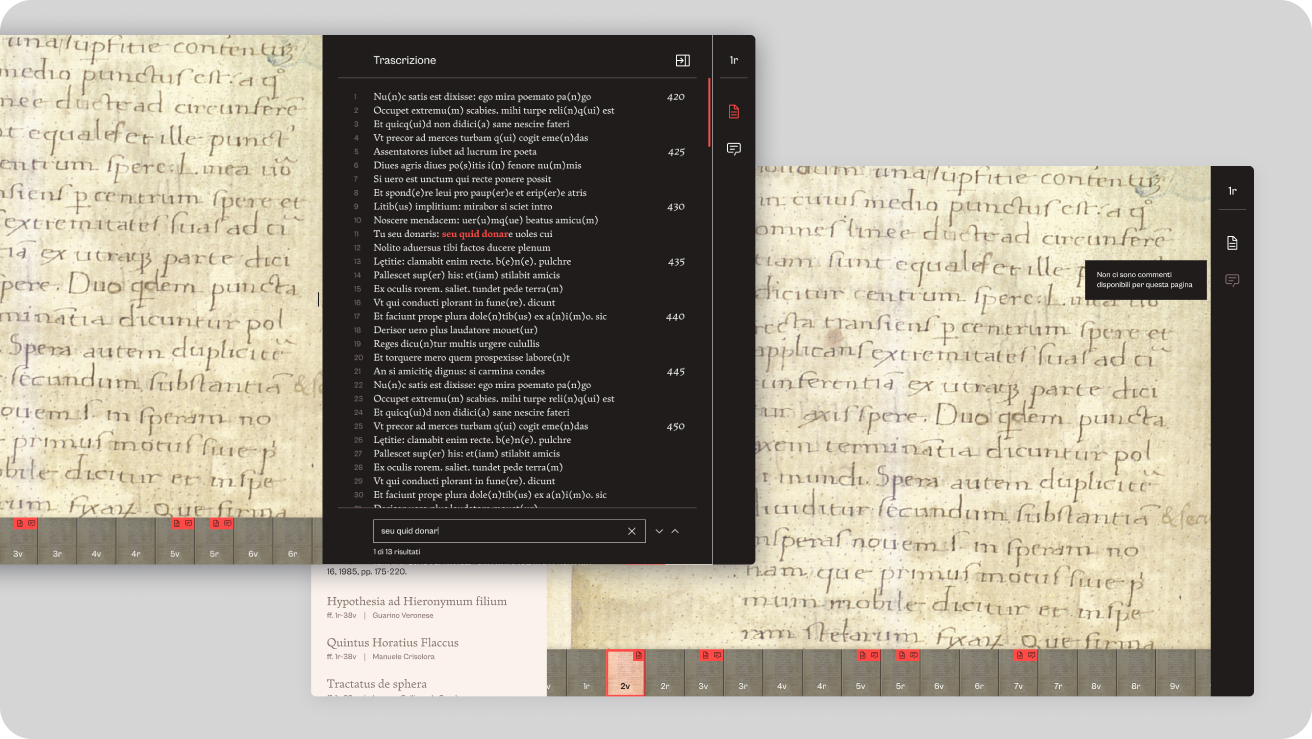
La trascrizione ha senso solo se il lettore sa a quale carta appartiene. Serviva un modello capace di legare ogni immagine alla sua trascrizione, gestendo il fatto che la numerazione delle carte di un manoscritto non parte necessariamente da 1 e non procede sempre con passo regolare.
Una ricerca da filologi, non da e-commerce
La ricerca per parola chiave è insufficiente. Il requisito era cercare due termini, in forma esatta o parziale, combinati in AND o in OR, e soprattutto entro una distanza massima l'uno dall'altro nel testo. Nessun CMS offre questo operatore di serie.
Bilinguismo su contenuti scientifici
Schede di biblioteca, descrizioni dei codici, pagine editoriali e interfaccia devono esistere in italiano e in inglese, con la possibilità di tradurre ogni entità del modello dati senza duplicare i contenuti.
Autonomia totale del gruppo di ricerca
Le schede sono testi lunghi, con sottotitoli, note e immagini corredate da didascalia. Devono poter essere scritte, riviste e pubblicate da chi fa ricerca, senza passare dallo sviluppo e senza attendere un rilascio.
Contenuti pesanti da servire con leggerezza
Scansioni ad alta risoluzione e PDF di grandi dimensioni non possono penalizzare i tempi di caricamento delle pagine di consultazione.
Privacy by design
Nessuna registrazione utente, nessun dato raccolto, nessun contenuto incorporato da social network. Ne consegue un sito che non ha bisogno di un banner cookie.
La soluzione
Un modello dei dati che ricalca la struttura del codice
Abbiamo modellato il dominio su quattro livelli annidati, invece del più semplice binomio 'libro/pagina' usato di solito:
- Il primo livello è la biblioteca, che contiene i manoscritti.
- Il secondo è il manoscritto, con la sua segnatura attuale, le segnature antiche, la copertina e due versioni scaricabili in PDF.
- Il terzo è l'opera: ogni manoscritto può contenere più opere diverse, ciascuna con il proprio autore e il proprio intervallo di carte.
- Il quarto è la singola carta, con la sua immagine e la sua trascrizione.
Su ogni entità sono agganciate le traduzioni, in modo che il passaggio dall'italiano all'inglese non richieda contenuti duplicati. Alla trascrizione di ogni carta abbiamo aggiunto due parametri di configurazione (numero di partenza e intervallo) che permettono alla redazione di allineare la numerazione mostrata a quella reale del codice, senza toccare il codice sorgente.
Il visore e la trascrizione, sullo stesso schermo
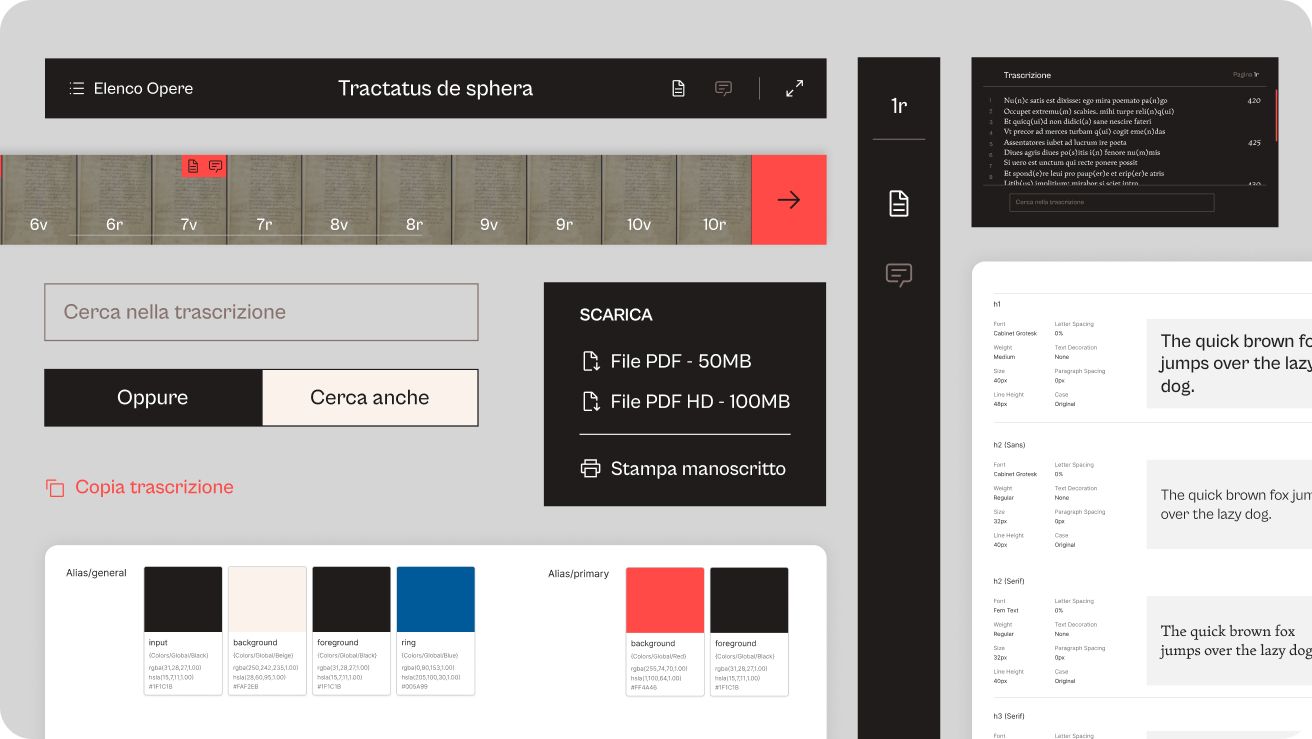
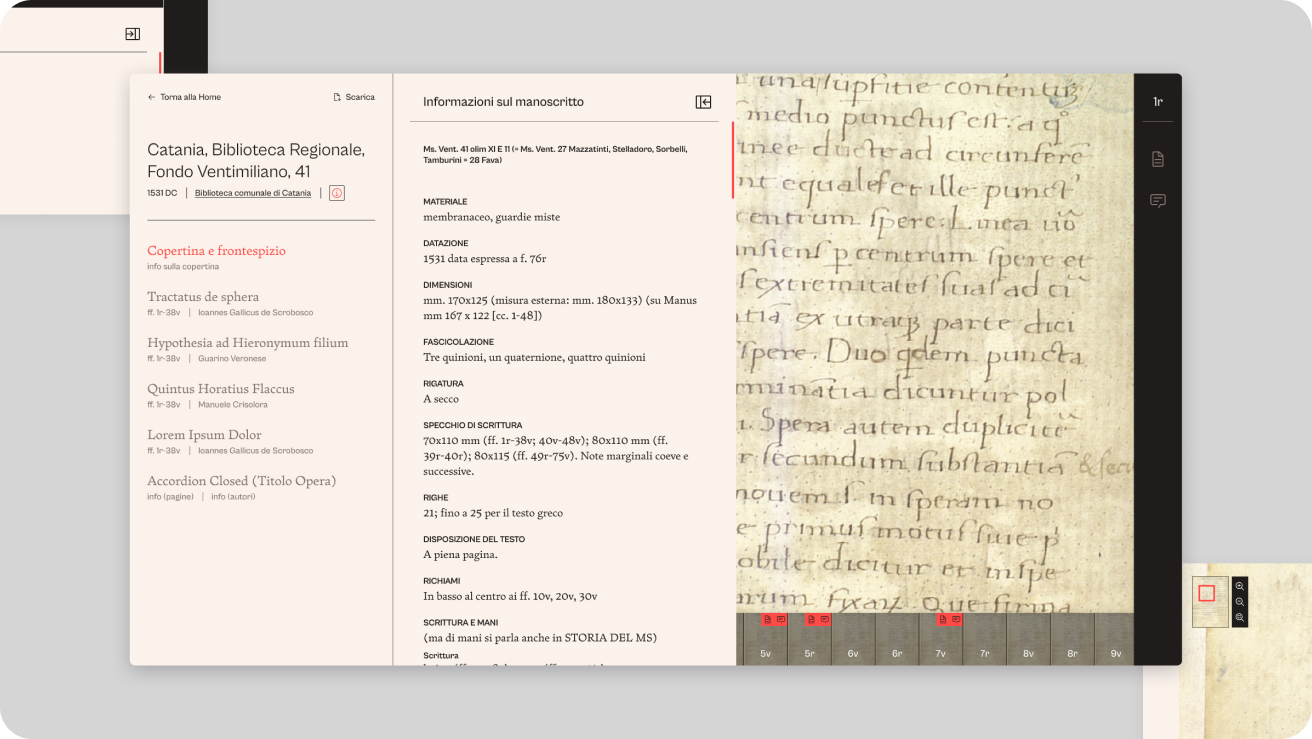
La pagina di consultazione di un manoscritto è costruita a pannelli affiancati e ridimensionabili. Da un lato il visore dell'immagine, con zoom e trascinamento per leggere la scrittura da vicino. Dall'altro le sezioni che accompagnano la lettura: l'indice dei contenuti del codice, i metadati codicologici, la trascrizione e l'apparato di commento. La trascrizione si può copiare con un gesto, e il codice completo si scarica in due varianti PDF, una standard e una in alta risoluzione.
Una ricerca pensata per i filologi, non scontata da costruire
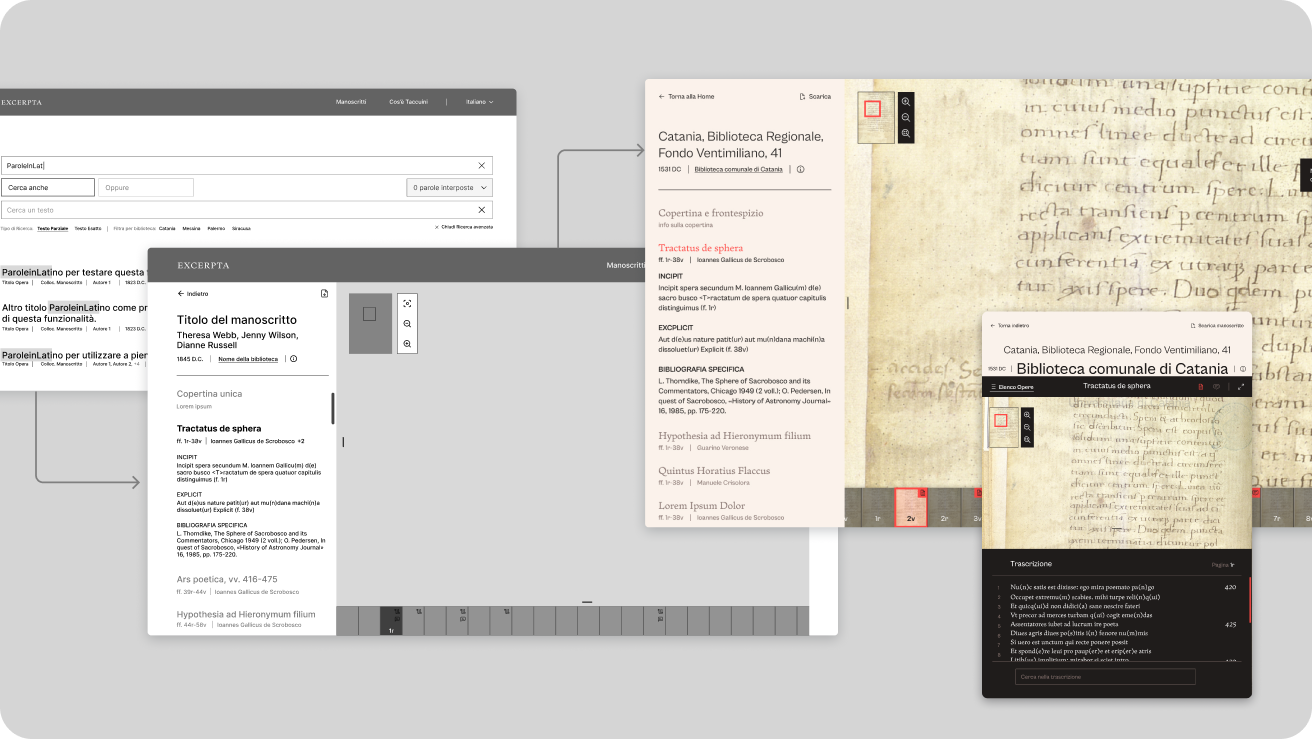
Il requisito arrivato dal gruppo di ricerca sembrava semplice: “vogliamo trovare le carte in cui due termini compaiono a poca distanza l'uno dall'altro”. Per chi studia testi è una funzione ovvia, perché le co-occorrenze rivelano formule, citazioni, riprese. Ma è assente in quasi tutti i motori di ricerca dei CMS, che ragionano per campo e per corrispondenza, non per distanza fra due parole dentro un testo.
Il primo tentativo naturale era delegare tutto al CMS. Il problema è che il linguaggio di filtro di un CMS headless sa dire 'questo campo contiene questa stringa', non 'questa stringa compare entro cinque parole da quest'altra'. Anche l'alternativa opposta, scaricare tutte le trascrizioni e cercare in memoria, ha il suo problema: fa transitare l'intero corpus a ogni ricerca.
Abbiamo scelto la via intermedia, in due fasi. La prima fase interroga il CMS con un filtro costruito dinamicamente, che restringe l'insieme alle sole carte pubblicate che contengono almeno i termini richiesti, applicando anche l'eventuale filtro per biblioteca. La seconda fase lavora sul sottoinsieme così ottenuto e vi applica un pattern di prossimità generato al volo: fra i due termini viene inserita un'espressione che consuma un numero definito di parole intermedie, e le carte che non soddisfano il pattern vengono scartate.
Sulla stessa logica abbiamo innestato le altre due dimensioni della ricerca. La ricerca esatta circonda i termini con delimitatori di parola, così che «ars» non risponda dentro «arsenale». La ricerca parziale, invece, li lascia aperti da entrambi i lati: un comportamento indispensabile su testi con abbreviazioni e grafie non normalizzate. I termini inseriti dall'utente vengono sempre neutralizzati prima di entrare nel pattern, perché un testo latino può contenere caratteri che altrimenti verrebbero interpretati come istruzioni di ricerca.
L'ultimo passaggio è quello che rende il risultato leggibile: le occorrenze trovate vengono evidenziate direttamente nella trascrizione restituita, così che lo studioso veda subito il contesto della coppia di termini invece di doverlo cercare a occhio dentro il paragrafo.
Pubblicare senza aspettare
Il portale è generato staticamente per essere veloce: le pagine sono già pronte quando l'utente le richiede, invece di essere costruite al momento. Normalmente, però, un sito così si aggiorna solo con una nuova build completa, che può richiedere qualche minuto. Per un gruppo di ricerca che scrive e corregge schede ogni giorno, era un tempo di attesa da eliminare.
Abbiamo costruito un sistema di invalidazione mirata: un endpoint dedicato viene richiamato dal CMS a ogni modifica, riconosce quale tipo di contenuto è cambiato (una scheda di biblioteca, un manoscritto, una pagina editoriale, persino il dizionario delle etichette d'interfaccia) e rigenera solo le porzioni di cache interessate, non l'intero sito. Per la redazione, salvare in CMS equivale a pubblicare.
Anche i testi lunghi delle schede restano interamente in mano a chi fa ricerca: si scrivono in Markdown, che il portale interpreta al volo. Sottotitoli, note e immagini con didascalia sono a disposizione della redazione senza bisogno di un intervento di sviluppo per ogni variazione di impaginazione.
Un connettore verso il CMS, isolato in libreria
Il modo in cui il portale dialoga con il CMS non è sparso qua e là nel codice: passa sempre da un unico punto. Ogni richiesta di lettura, scrittura o modifica attraversa questo stesso livello, che controlla anche la qualità di ogni risposta prima che arrivi alle pagine del sito.
Questo ha un effetto molto concreto: se un contenuto arriva scritto male o incompleto, viene intercettato subito, all'origine invece di arrivare fino alla pagina e mostrarsi come un errore o uno schermo bianco a chi sta consultando il sito. E se in futuro si volesse cambiare CMS, basterebbe intervenire su questo unico punto, senza dover riscrivere il resto dell'applicazione.
Dati aperti, non solo un sito
Le due funzioni di ricerca del progetto (quella per autore e opera sui manoscritti, quella per termini dentro le trascrizioni) non sono chiuse dentro il sito. Sono aperte anche a chi vuole usarle da fuori: altri strumenti, altri progetti di ricerca, altre piattaforme.
Per farlo, ogni ricerca è raggiungibile anche come un servizio a sé stante, con una documentazione consultabile online che spiega esattamente come interrogarla. Significa che i dati raccolti possono circolare ed essere riusati, in linea con lo spirito open access di Excerpta.
Architettura e tecnologie
- Frontend: Next.js con App Router e rendering server-side, React e TypeScript, internazionalizzazione con next-intl su rotte per lingua, componenti accessibili basati su primitive Radix UI, visore immagini con zoom e pan, resa Markdown a runtime, validazione dei dati con Zod, libreria di componenti documentata in Storybook.
- Contenuti: CMS headless Directus containerizzato, con schema tradotto su tutte le entità e gestione dei media; invalidazione selettiva della cache tramite webhook verso il portale.
- Monorepo: workspace pnpm orchestrato con Nx, libreria condivisa per il connettore CMS, set di comandi standardizzato secondo le convenzioni Devmy, controlli su commit e versioning automatizzato.
- Delivery: pipeline GitLab CI con due ambienti — anteprima sul branch di sviluppo e produzione sul branch principale — deploy del portale su Vercel e del CMS su infrastruttura containerizzata; configurazione applicativa gestita in forma cifrata e iniettata in fase di build.
- Osservabilità: monitoraggio degli errori in produzione con Sentry, con source map non esposte pubblicamente.
Risultati e impatto
La collezione diventa consultabile da chiunque
Le scansioni, le schede codicologiche e le trascrizioni sono raggiungibili dal web senza appuntamento e senza credenziali, con il codice completo scaricabile in due qualità.
La ricerca filologica si fa online
Cercare due termini a distanza controllata dentro le trascrizioni è un'operazione che prima richiedeva la lettura integrale del codice; ora è una query.
Il gruppo di ricerca è autonomo sui contenuti
Schede, pagine editoriali e trascrizioni si scrivono e si pubblicano dal CMS, e il sito si aggiorna da sé sulle sole parti interessate.
Il progetto parla due lingue
L'intera piattaforma, contenuti scientifici compresi, è disponibile in italiano e in inglese, requisito indispensabile per la circolazione internazionale dei materiali.
I dati sono riusabili
Le ricerche sono esposte come API documentata, in linea con l'impostazione open access di Excerpta.
Privacy per gli utenti
L'assenza di registrazione, di raccolta dati e di contenuti incorporati da terze parti è una scelta di progetto, non una mancanza.
Quello che prima richiedeva un viaggio in biblioteca, un appuntamento e la lettura di un intero codice, oggi è una ricerca che parte da un browser. Non solo un sito più moderno, ma uno strumento in più per la ricerca filologica, costruito insieme a chi quella ricerca la fa ogni giorno.